Ton IA ne comprend rien à ce que tu lui dis. Et c'est exactement pour ça qu'elle marche.
Sur mon compte, vous découvrirez le détail de mes multiples expériences grace au nouveaux outils d'IA et d'automatisation qui révolutionne la facon dont nous travaillons depuis 2022.
Je me rappelle encore de l’internet de quand j’avais une dizaine d’années. Il existait déjà des chats depuis lesquels tu pouvais discuter avec des robots. Mais entre nous, c’était pas la folie. (Si d’ailleurs quelqu’un est capable de me ressortir le nom de ce chatbot, je suis preneur, car il m’échappe !) Entre les réponses totalement insensées et le manque de mémoire du système, personne ne voyait en cela autre chose qu’un jouet amusant pour se divertir au maximum 5 minutes.
Comment la révolution a-t-elle pu avoir lieu si vite, et amener un Français sur deux à l’utiliser ?
Pendant longtemps, j'ai utilisé ces outils sans vraiment chercher à comprendre ce qui se passait sous le capot. Et honnêtement, j'aurais évité pas mal d'erreurs, et quelques surprises, si j'avais compris plus tôt les 4-5 concepts que je vais te présenter ici. Sans technicité, sans contenu superflu.
La publication qui a tout changé
Contrairement à ce que beaucoup pensent, la révolution de l’IA générative n’a pas démarré en 2022 avec la sortie de ChatGPT. Elle a commencé cinq ans plus tôt, en 2017, avec la publication d’un article scientifique intitulé Attention Is All You Need, dans lequel des chercheurs de Google Research ont présenté une nouvelle architecture appelée transformer.
Concrètement, ils ont mis au point un mécanisme appelé attention, qui permet à un modèle d’IA d’identifier les éléments les plus pertinents parmi une grande quantité d’informations. Au lieu de traiter chaque mot avec la même importance, le modèle apprend à se concentrer sur ce qui est le plus utile pour comprendre le contexte.
On peut comparer ça à la lecture d’un texte complexe : tu ne donnes pas le même poids à chaque mot. Tu repères instinctivement les termes importants. Les transformateurs cherchent à reproduire ce comportement à très grande échelle.
C’est cette architecture qui a rendu possible l’entraînement de modèles contenant des centaines de milliards de paramètres. La véritable rupture, ce n’est pas ChatGPT en 2022, c’est ce papier de recherche en 2017, que personne n’a vu venir en dehors du milieu académique.
Le token
Pour comprendre comment un LLM fonctionne, et surtout combien il coûte à faire tourner, il faut d’abord parler de la brique de base : le token.
Un token correspond en français à environ 1,5 à 2 mots, ou 3 à 4 caractères en moyenne. Deux repères utiles à garder en tête :
1 token ≈ 3 à 4 caractères en français
1 000 tokens ≈ 750 mots environ
Pourquoi ton prompt de 500 mots coûte moins cher que la réponse de 100 mots
C’est le truc qui m’a le plus surpris quand j’ai commencé à utiliser les LLM via API pour mes automatisations. Je m’attendais à payer à la longueur de ma question. La réalité est plus subtile.
Les modèles distinguent deux flux : les tokens en entrée (ton prompt) et les tokens en sortie (la réponse générée). Les tokens de sortie sont bien plus onéreux, parce que lire du texte et en fabriquer du nouveau, ce n’est pas le même effort. Les tokens d’entrée, c’est du traitement de contexte. Les tokens de sortie, c’est calculer chaque mot pas à pas, ce qui est bien plus coûteux en infrastructure.
Tu peux vérifier ça directement dans la section pricing de chaque modèle si tu passes par l’API.
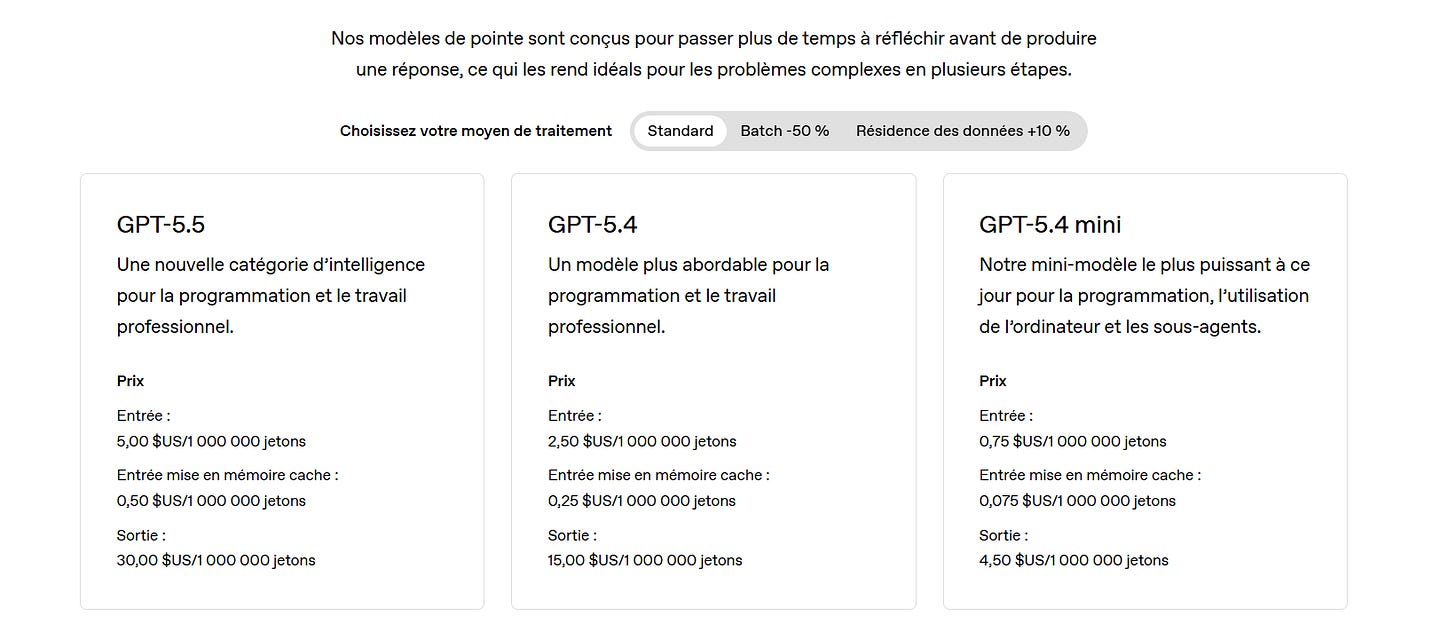
OpenAI facture également la "mise en cache mémoire" : du texte déjà vu et réutilisé à l'identique est facturé bien moins cher. Si tu lui renvoies le même bloc, il s'en souvient de manière éphémère (entre 5 minutes et 1 heure). Si tu modifies légèrement ce texte, la partie changée repasse au tarif normal.
Entraîner un modèle IA
Avant de pouvoir générer quoi que ce soit, un modèle doit apprendre le langage. Comme un nouveau-né, il faut lui insuffler tout depuis zéro. GPT-4 a été entraîné sur des centaines de milliards à des trillions de tokens, soit des dizaines de millions de pages de texte.
La source principale ? Des corpus web comme Common Crawl, un dépôt de plus de 300 milliards de pages crawlées sur internet. Complété par des sources plus structurées : Wikipédia, des livres, du code, des articles de presse.
Mais ces données ne sont pas toujours propres, ni légales. Anthropic, le créateur de Claude que j'utilise quotidiennement dans mes workflows, a été poursuivi à l'automne 2025 par un collectif d'écrivains, accusé d'avoir entraîné son IA sur des centaines de milliers de livres piratés. L'affaire s'est conclue par un accord de 1,5 milliard de dollars, chaque auteur concerné touchant jusqu'à 3 000 dollars par ouvrage. Meta, OpenAI et Apple font face à des plaintes similaires. Le flou juridique est encore largement réel, surtout hors d'Europe. Ça avance, mais beaucoup plus lentement que le développement des modèles.
Pourquoi les modèles hallucinent
C’est probablement la chose la plus importante à comprendre si tu utilises ces outils pour du travail réel.
Quand tu envoies un prompt à un LLM, il ne sait pas et ne comprend pas la réponse. Il calcule token par token la séquence de mots la plus probable, c’est ce qu’on appelle l’inférence. Il n’a pas accès à une “vérité” quelque part. Il imite le style d’un texte vrai, même si le contenu est faux. La fluidité de la réponse prévaut sur la véracité des faits.
C’est la première fois que j’ai vraiment compris pourquoi mes agents n8n sortaient parfois des résultats absurdes avec une confiance déconcertante. Ce n’était pas un bug. C’était le modèle qui faisait exactement ce pour quoi il était conçu.
Pour limiter ça, les créateurs des modèles exposent un paramètre appelé “température”. Une température basse rend le modèle plus déterministe, il choisit systématiquement les tokens les plus probables. Une température haute le rend plus créatif, parfois trop. Depuis n8n, je passe ce paramètre directement à Mistral selon le type de tâche : basse pour de l’extraction de données, plus haute pour de la rédaction.
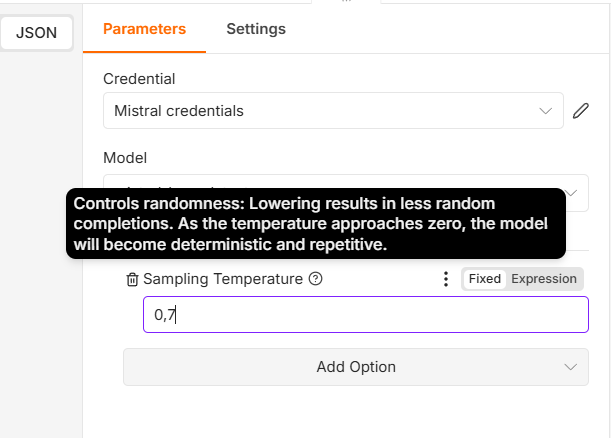
Depuis une interface chat classique, tu ne peux pas le modifier directement, mais tu peux l'influencer via tes instructions système dans les paramètres du modèle, ou simplement en étant plus ou moins directif dans ton prompt.
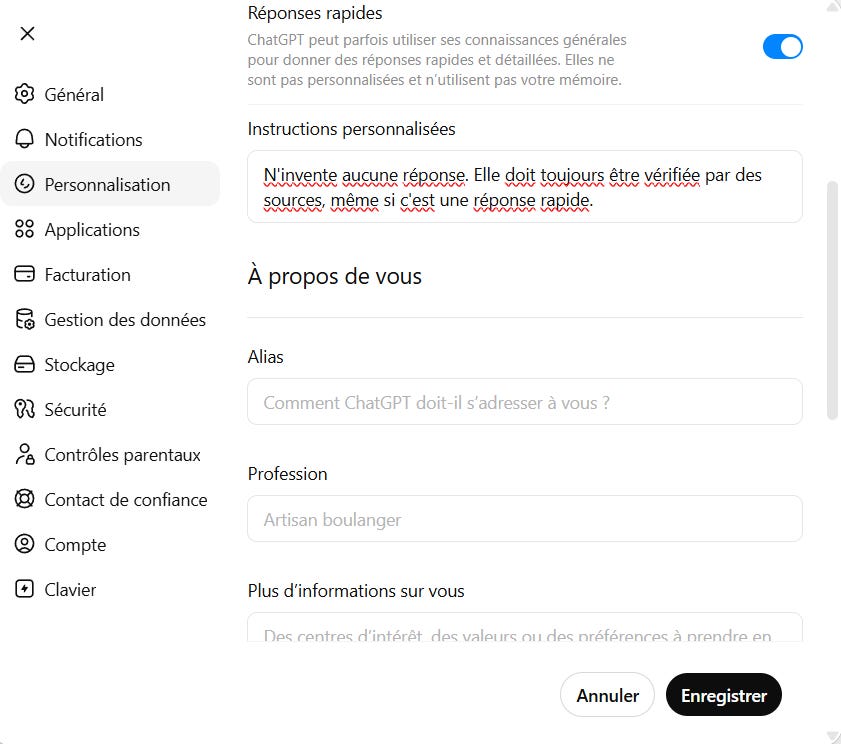
Les progrès entre 2022 et aujourd'hui sont réels : les modèles hallucinent bien moins, en partie parce qu'ils peuvent rechercher sur internet en temps réel, mais aussi parce que les utilisateurs ont appris à prompter avec plus de précision.
La fenêtre de contexte
Dernier concept, et celui qui change le plus la façon de construire des automatisations.
À chaque message que tu envoies à un LLM, il ne “se souvient” pas de la conversation précédente comme le ferait un humain. Il relit tout depuis le début à chaque échange. La fenêtre de contexte, c’est tout ce que le modèle peut voir en même temps, et elle est limitée.
Claude a par exemple une fenêtre de 200 000 tokens, soit environ 150 000 mots. Passée cette limite, le modèle ne plante pas, il oublie. Les messages les plus anciens disparaissent. C’est pour ça qu’au bout d’une longue conversation, il “oublie” ce que tu lui as dit au début.
Ce que ça change concrètement :
Dans une conversation chat : après 2 heures sur un sujet complexe, il ne sait plus ce que tu lui as dit en début de session. Pas un bug, une limite physique.
Dans une automatisation : c’est critique. Chaque token de contexte que tu passes coûte de l’argent et réduit la place disponible pour la réponse. Un agent qui reçoit trop d’historique devient incohérent, ou hors de prix.
Pour les documents : coller un PDF de 50 pages à Claude mange une grosse partie de la fenêtre. Il reste moins de place pour une réponse détaillée. C’est quelque chose que j’ai dû apprendre à gérer dans mes workflows.
Voilà pour les bases.
Un LLM, c’est une machine qui prédit le prochain mot, pas qui comprend, ou qui réfléchit. Elle a été nourrie sur des quantités de texte inimaginables, elle découpe tout en tokens, et elle ne voit le monde qu’à travers une fenêtre limitée qu’elle relit entièrement à chaque échange.
Ce qui m’a le plus changé la façon de travailler quand j’ai intégré tout ça, c’est de réaliser que prompter c’est en réalité gérer de la mémoire et de la probabilité. Pas donner des ordres à un assistant intelligent, mais guider un comportement via une définition précise des besoins.
La prochaine fois qu’un modèle te sort une énormité avec aplomb, tu sauras pourquoi : il n’a pas menti, il a juste calculé la suite la plus probable. Et personne ne lui a appris à avoir honte. 😜
Construire avec l'IA
Recevez chaque nouvel article par e-mail, gratuitement, dès sa parution sur Substack.