Qu'est-ce que Jev, l'IA qui décide au lieu de répondre
TypeSafe AI a sorti Jev, un modèle qui ne génère pas de texte mais rend des décisions structurées et calibrées. Testé sur 22 factures réelles : les chiffres, l'accès et les limites.
Depuis le 15 septembre, TypeSafe AI propose Jev, un modèle d'intelligence artificielle qui ne rentre pas dans la catégorie habituelle des grands modèles de langage (LLM). L'entreprise, fondée en 2024 par Diogo Almeida (co-auteur de l'article de recherche InstructGPT, à l'origine de ChatGPT), est sortie de stealth (le silence médiatique qui précède le lancement public d'une entreprise) avec 40 millions de dollars levés en amorçage (seed) auprès du fonds DCVC.
Un modèle qui décide, plutôt qu'il ne rédige
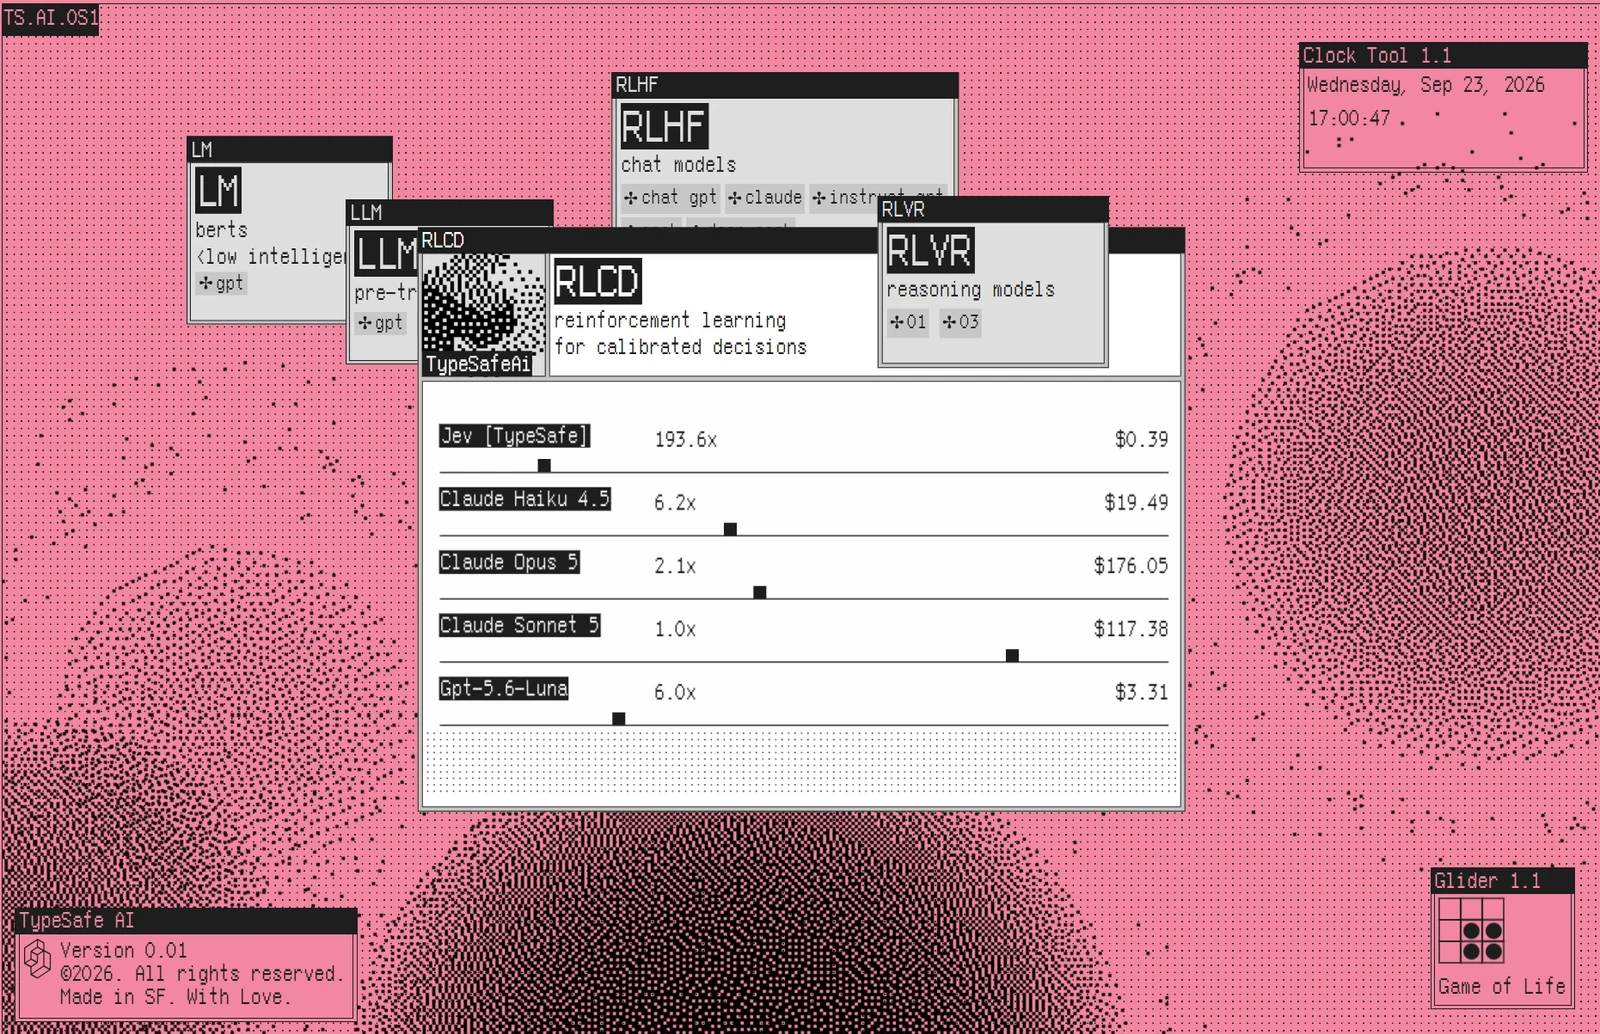
Un LLM classique génère du texte : on lui pose une question, il produit une réponse en langage naturel, parfois longue, parfois ambiguë. Jev fonctionne autrement. TypeSafe AI le range dans une nouvelle catégorie, les « System One Models », en référence à la pensée rapide et intuitive plutôt qu'à la réflexion lente et délibérée.
Concrètement, Jev prend en entrée un contexte (un email, un document, une situation) et une liste d'options prédéfinies, puis retourne directement une décision structurée : une catégorie, un score, ou une réponse oui/non, accompagnée d'un pourcentage de confiance. Pour classer un email entre support, facture, litige ou spam, Jev ne rédige pas de phrase : il répond directement « Demande client, confiance 0,91 ».
Le compromis coût, vitesse, précision
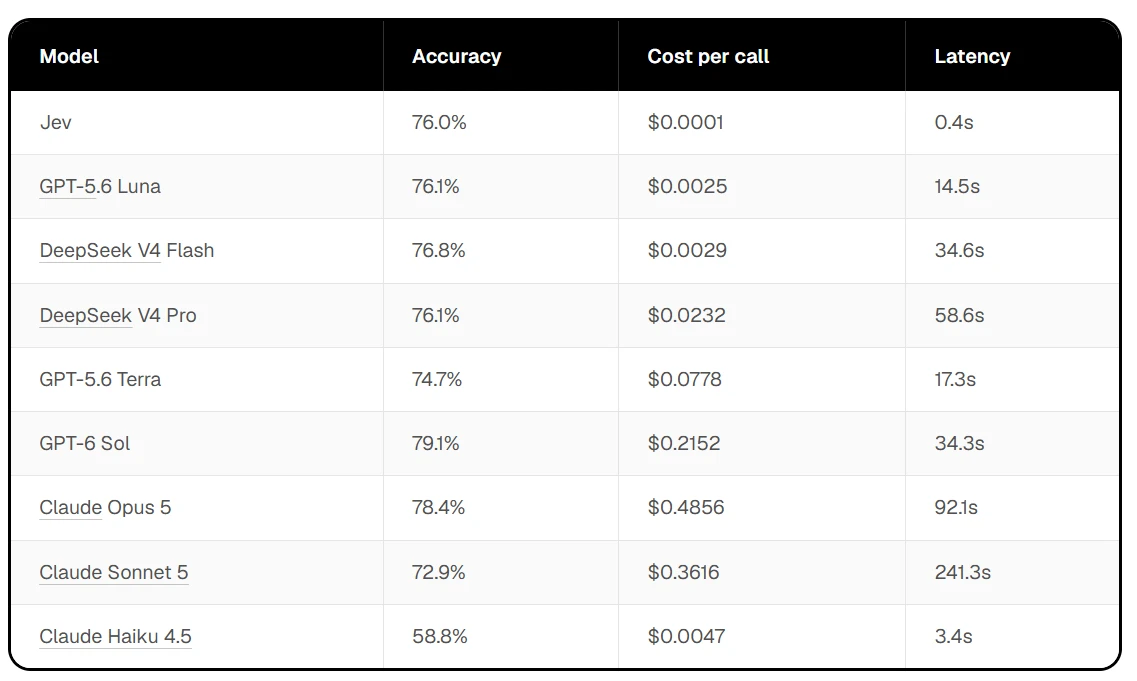
Jev coûte 0,042 $ par million de tokens (l'unité de mesure du texte traité par un modèle) en entrée, et rien en sortie puisqu'il ne génère pas de texte. Pour une décision typique d'environ 2 400 tokens, cela revient à 0,0001 $. Face à GPT-5.6 Luna (0,0025 $ par appel, 25 fois plus cher) ou Claude Opus 5 (0,4856 $ par appel, près de 5 000 fois plus cher), l'écart est net.
Le même écart se retrouve sur la vitesse : Jev répond en 0,4 seconde en moyenne, contre 92 secondes pour Claude Opus 5 sur une tâche de classification comparable.
Cet avantage a une contrepartie : la précision de Jev, mesurée par TypeSafe AI, est de 76 %, contre 78,4 % pour Claude Opus 5 et 79,1 % pour GPT-6 Sol. Pour une tâche de classification à fort volume et faible enjeu individuel (trier des emails, router des tickets), un écart de 2 à 3 points de précision compte moins qu'être 200 fois plus rapide et des milliers de fois moins cher. Pour une décision individuelle à fort enjeu, le calcul s'inverse.
Test sur 22 factures réelles
Pour vérifier ces chiffres sur un cas concret, un test a été mené sur 22 factures et reçus réels (janvier à septembre 2026) : grande distribution, bricolage, électroménager, entretien, services professionnels et hébergement. Chaque document a été soumis à Jev avec deux questions : la catégorie comptable, parmi six options, et un score indiquant si le montant est clairement exploitable pour une saisie automatique.
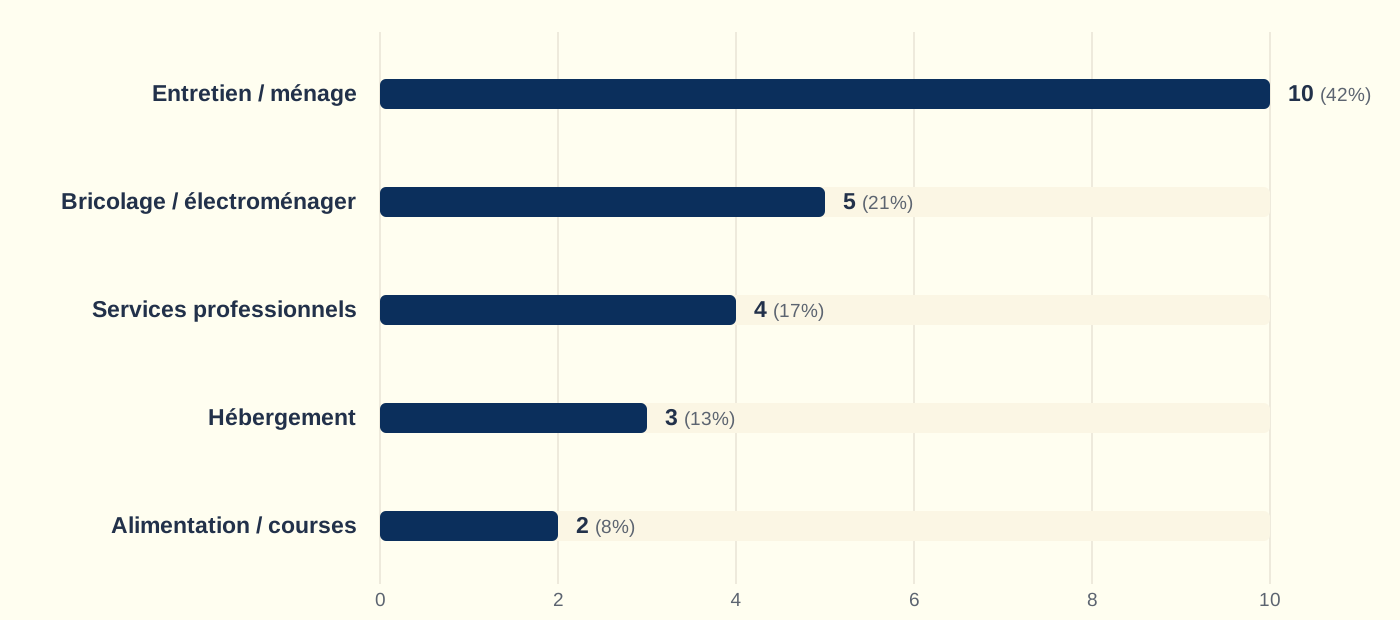
Les 22 documents ont été traités en 16,2 secondes au total, soit environ 440 millisecondes par requête en moyenne (321 à 558 ms, hors un pic isolé à 6,6 secondes, probablement un temps de démarrage du service). La répartition obtenue, 10 factures d'entretien, 5 de bricolage ou d'électroménager, 4 de services professionnels, 3 d'hébergement et 2 d'alimentation, correspond exactement à la nature réelle de chaque fournisseur.
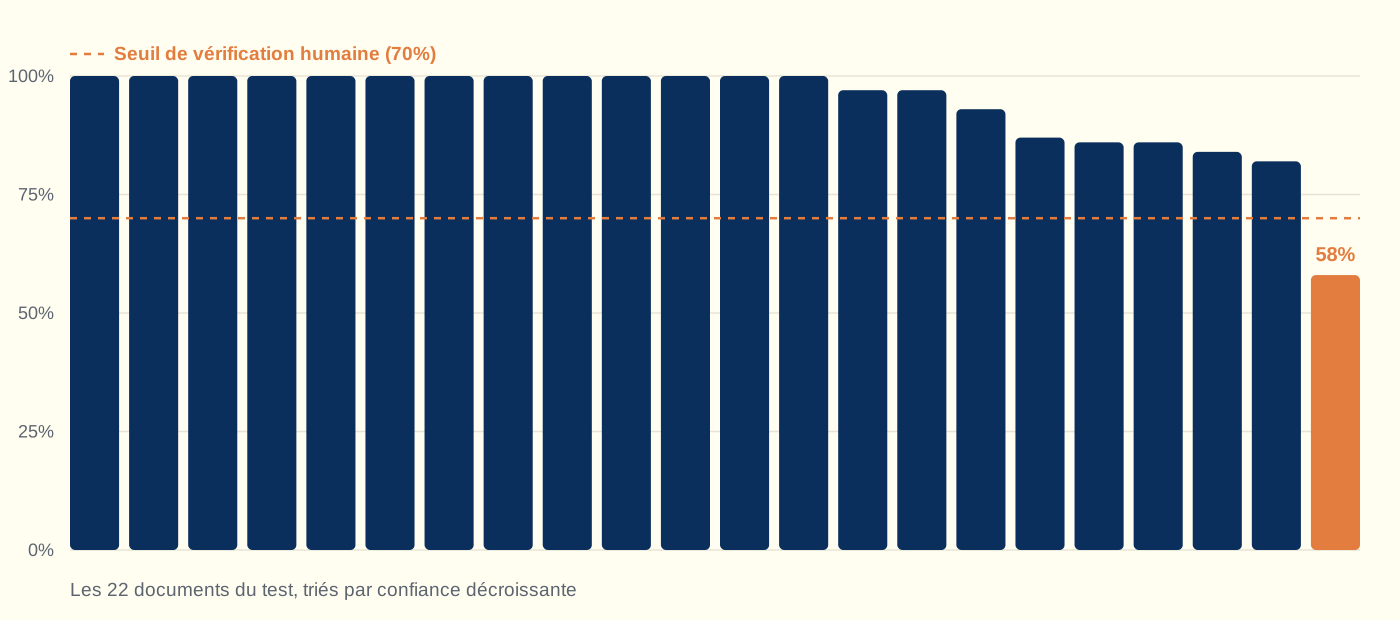
Le point le plus utile du test porte sur la confiance calibrée. Sur les documents sans ambiguïté, une facture de bricolage, un reçu de supermarché, Jev répond avec 97 à 100 % de confiance. Sur un document mêlant plusieurs types de produits, la même facture combinant un article d'entretien et du petit électroménager, la confiance retombe à 58 %, avec une répartition cohérente entre les deux catégories concurrentes (58 % entretien, 29 % bricolage). Le score de confiance ne se contente pas d'accompagner la réponse : il reflète l'ambiguïté réelle du document. Cela permet de fixer un seuil de routage automatique : sous un certain pourcentage, par exemple 70 %, le document part en vérification humaine plutôt que d'être saisi automatiquement.
Deux limites sont apparues pendant ce test : 8 des 22 documents étaient des scans sans texte exploitable, nécessitant un OCR (reconnaissance optique de caractères) en amont, puisque Jev ne lit pas les fichiers binaires ; et un RIB bancaire a été volontairement exclu de l'envoi, pour ne pas transmettre de coordonnées bancaires à un service tiers.
Accès
Jev est disponible via Vercel AI Gateway, sous le nom de modèle typesafe-ai/jev, ou directement via l'API de TypeSafe AI. Via Vercel, l'authentification se fait par un jeton OIDC (un identifiant technique temporaire), généré avec la commande vercel link puis renouvelé par vercel env pull toutes les 12 heures : pas de clé API classique à copier-coller. Ce mode d'accès convient mieux à une application déjà hébergée sur Vercel qu'à un script ponctuel.
Limites
Jev n'est pas un remplacement des LLM classiques, il répond à un autre besoin. Il ne génère pas de texte, ne lit pas les fichiers binaires, et sa précision reste légèrement en retrait des meilleurs modèles généralistes. Sa place naturelle : les décisions structurées à fort volume, où la vitesse et le coût comptent davantage que la nuance d'une réponse rédigée, avec un score de confiance exploitable pour distinguer les cas nets des cas à vérifier.